
Số hóa lưu trữ với AI: kinh nghiệm làm ứng dụng bằng vibe coding
Trong bài này
Trong một dự án số hóa tài liệu lưu trữ cho cơ quan nhà nước, tôi gặp một bài toán rất quen: kho tài liệu giấy đã được scan thành hàng nghìn file PDF, nhưng để đưa vào Hệ thống lưu trữ số thì mỗi văn bản phải có metadata đầy đủ, đúng quy định, rồi đóng gói theo Thông tư 05/2025/TT-BNV. Làm tay thì đội cán bộ lưu trữ mất hàng tháng, lại dễ sai sót. Tôi quyết định dựng một ứng dụng riêng, và làm phần lớn bằng vibe coding với Claude Code. Bài này kể ở mức tổng quan: ứng dụng làm gì, và tôi rút ra điều gì từ cách làm.
Bài toán thật
Một đợt số hóa thường có ba nỗi đau:
- Khối lượng: thư mục PDF lồng nhiều tầng, đặt tên theo quy ước của từng đơn vị, chỗ nhất quán chỗ không.
- Nhập metadata: số, ký hiệu, ngày tháng, trích yếu, tác giả văn bản… cho từng tài liệu. Việc này lặp lại và rất dễ nhầm.
- Kiểm tra trước khi nộp: thiếu file, sai thứ tự, ngày tháng bất thường, lệch mục lục. Lỗi phát hiện muộn thì sửa rất tốn công.
Người dùng cuối là cán bộ lưu trữ và nhân viên dò hồ sơ, không phải dân IT. Điều này quyết định rất nhiều thứ về giao diện và cách báo lỗi.
Ứng dụng làm gì
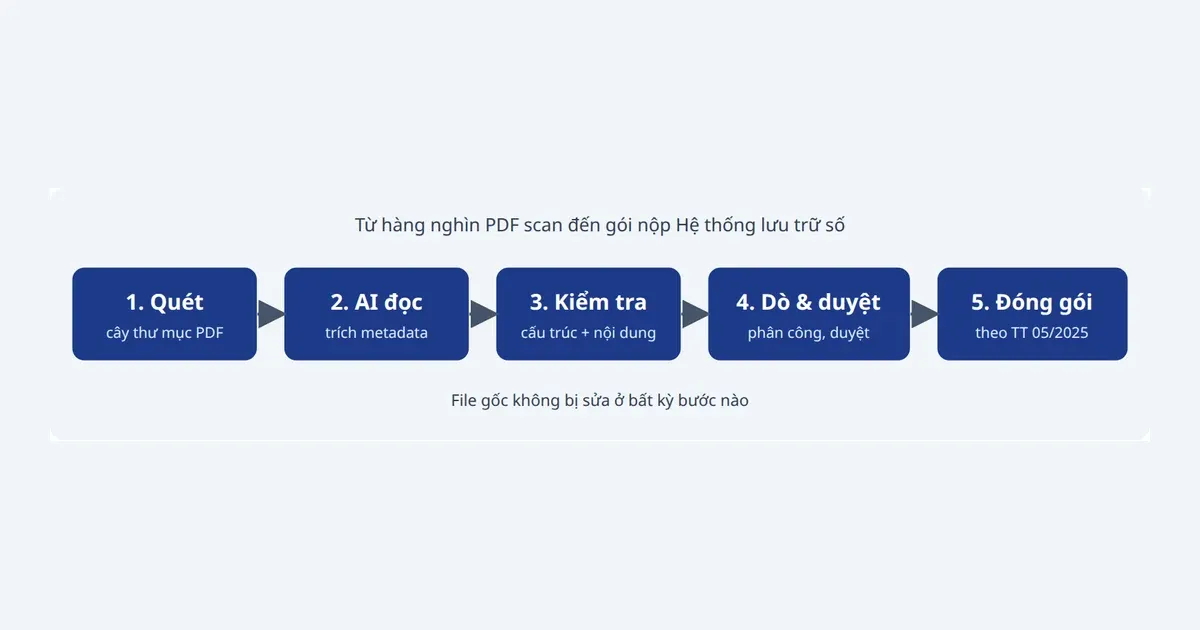
Ở mức chức năng, ứng dụng đi qua năm bước:
- Quét cây thư mục PDF vào một dự án, nhiều dự án chạy song song được.
- AI đọc từng văn bản và đề xuất các thông tin cần thiết theo thể thức văn bản hành chính.
- Kiểm tra hai lớp: lớp cấu trúc (thư mục, tên file, thứ tự) và lớp nội dung (thiếu mô tả, ngày bất thường, lệch mục lục).
- Dò và duyệt: quản trị viên phân công hồ sơ cho nhân viên, nhân viên chỉnh sửa và nộp, người duyệt xem lại, trả lại hoặc chấp nhận.
- Đóng gói theo Thông tư 05/2025/TT-BNV để nộp vào Hệ thống lưu trữ số.
Xung quanh đó là phần “vận hành” mà dự án chính quyền nào cũng cần: phân quyền theo vai trò, phân loại độ mật của tài liệu, nhật ký ghi lại ai đã xem hay tải file nào, báo cáo năng suất. Với tài liệu có độ mật, việc truy cập phải để lại dấu vết, nên nhật ký không phải tính năng làm cho đẹp.
Có một nguyên tắc tôi đặt ngay từ đầu: không bao giờ sửa file gốc. Mọi thao tác đều làm trên bản ghi mô tả và bản đóng gói; PDF nguồn không bị đổi tên, di chuyển hay xóa. Với dữ liệu lưu trữ, đây là điều kiện để cán bộ dám dùng công cụ.
Dạy AI đọc văn bản hành chính Việt Nam
Văn bản hành chính của ta có thể thức khá chặt, quy định tại Nghị định 30/2020/NĐ-CP: quốc hiệu, tên cơ quan, số và ký hiệu, địa danh, ngày tháng, trích yếu, nơi nhận, người ký. Đây vừa là lợi thế vừa là cái bẫy.
Lợi thế là bố cục tương đối ổn định, nên mô hình thị giác đọc rất tốt khi được hướng dẫn đúng. Cái bẫy là bản scan thực tế rất “bẩn”: con dấu đè lên chữ, chữ viết tay, trang nghiêng, văn bản cũ mờ, mẫu cũ khác mẫu hiện hành. Điều tôi học được ở đây khá giản dị:
- Hướng dẫn cho AI cần bám vào thể thức, đừng chỉ bảo nó “trích xuất thông tin”.
- Kết quả của AI chỉ là đề xuất. Con người luôn là người chốt, và giao diện phải làm cho việc rà soát nhanh.
- Cần các lớp kiểm tra sau AI, vì nó có thể tự tin nhưng sai.
AI giúp giảm phần gõ lại phần lớn, còn phần phán đoán vẫn thuộc về cán bộ lưu trữ.
Vibe coding trong thực tế
Tôi không ngồi nói chuyện lung tung với AI rồi hy vọng ra sản phẩm. Quy trình của tôi khá kỷ luật:
- Spec trước: mỗi giai đoạn bắt đầu bằng một tài liệu thiết kế ghi rõ mục tiêu, phạm vi và cả những thứ cố ý không làm. Brainstorm với Claude để thu hẹp, rồi mới chốt.
- Kế hoạch từng bước: spec được chia thành các task nhỏ, mỗi task có tiêu chí hoàn thành.
- Nhật ký thi công: sau mỗi giai đoạn tôi giữ lại lỗi đã gặp, bài học và các khoản còn nợ, còn kế hoạch chi tiết thì bỏ vì mã mẫu trong đó lệch khỏi mã thật rất nhanh. Nhật ký này cũng là bộ nhớ dài hạn cho cả tôi lẫn AI ở phiên làm việc sau.
- Test nhiều: dự án hiện có khoảng 1.500 test. Khi AI viết mã nhanh, test là thứ duy nhất cho tôi tự tin để sửa tiếp mà không sợ làm hỏng chỗ cũ.
Bài học quan trọng nhất
Nhiều lỗi thật chỉ lộ ra khi chạy với dữ liệu thật. Mã sạch, test xanh, linter im lặng, vậy mà lần đầu chạy trên một kho tài liệu thật là thấy ngay những trường hợp không ai nghĩ tới: tên thư mục viết hoa thường lẫn lộn, hai hồ sơ bị gộp nhầm thành một, tệp biến mất khỏi đĩa mà không ai báo. AI viết test dựa trên những gì nó tưởng tượng; thực tế luôn bẩn hơn tưởng tượng.
Vì vậy mỗi lỗi tìm ra từ dữ liệu thật đều được biến thành một test khóa lại, và ghi vào nhật ký. Tôi coi đây là cách duy nhất để vibe coding không biến thành “nhanh mà ẩu”.
Vài bài học khác:
- Cảnh báo thay vì chặn: ứng dụng nêu rõ vấn đề để cán bộ tự quyết, không tự động từ chối. Người nghiệp vụ hiểu ngoại lệ hơn phần mềm.
- Làm cho người không rành IT: tiếng Việt toàn bộ, thông báo lỗi nói bằng ngôn ngữ nghiệp vụ, thao tác hàng loạt cho việc lặp lại.
- Giữ phạm vi từng giai đoạn chặt: ghi rõ những gì không làm để khỏi tranh luận lại, và AI cũng đỡ “tiện tay” làm thêm.
- Rà soát giao diện định kỳ: AI làm giao diện chạy được rất nhanh, nhưng độ tinh chỉnh vẫn cần mắt người.
Kết
Vibe coding không thay thế việc hiểu nghiệp vụ. Phần giá trị nhất của tôi trong dự án này không phải gõ mã, mà là hiểu quy trình lưu trữ, đặt ra nguyên tắc (không sửa file gốc, cảnh báo không chặn), và kiên nhẫn đưa dữ liệu thật vào kiểm chứng. AI lo phần tốc độ; spec, test và dữ liệu thật lo phần đúng.
Nếu anh chị đang có một bài toán nghiệp vụ nội bộ tương tự và muốn thử hướng này, lời khuyên của tôi là: viết spec thật rõ, giữ nhật ký, và đừng tin bất cứ thứ gì cho đến khi nó chạy trên dữ liệu thật.