
Viết Claude Skill cho thẩm định tín dụng: những bài học thiết kế
Trong bài này
Gần đây tôi thử viết một Claude Skill để hỗ trợ khâu thẩm định tín dụng doanh nghiệp: nhận trọn bộ hồ sơ của khách hàng, đối chiếu số liệu và soạn bản nháp tờ trình đề xuất cấp tín dụng. Đây không phải sản phẩm đã đưa vào vận hành ở ngân hàng nào, mà là một dự án thử nghiệm để xem một agent skill đi được bao xa trong một nghiệp vụ nhiều quy tắc và nhiều rủi ro. Bài này tôi chỉ chia sẻ những bài học thiết kế chung, những gì áp dụng được cho bất kỳ skill nghiệp vụ nào.
Vì sao đáng viết một skill cho việc này
Ai từng làm cán bộ quan hệ khách hàng đều biết một bộ hồ sơ tín dụng doanh nghiệp tốn bao nhiêu công. Hồ sơ trải ra nhiều nhóm: pháp lý, tài chính, sao kê, hợp đồng mua bán, hợp đồng tín dụng cũ, hợp đồng thuê, CIC, ảnh thực địa, phương án vay. Có file Excel, PDF số, có cả những bản scan chụp nghiêng. Cán bộ phải gom, đọc, gõ lại số, đối chiếu giữa các nguồn, rồi mới viết tờ trình. Phần lớn thời gian không nằm ở phán đoán nghiệp vụ mà nằm ở thao tác lặp lại.
Đó đúng là kiểu việc agent làm tốt: khối lượng đọc lớn, quy trình khá rõ, đầu ra có khuôn mẫu. Skill đóng vai một bản hướng dẫn quy trình cho agent, kèm các tài liệu tham chiếu và script đi cùng. Điều tôi muốn kiểm chứng là liệu cán bộ có thể nhận về một bản nháp có nguồn dẫn, kèm danh sách điểm cần để mắt, thay vì bắt đầu từ trang trắng.
Luồng làm việc tổng thể
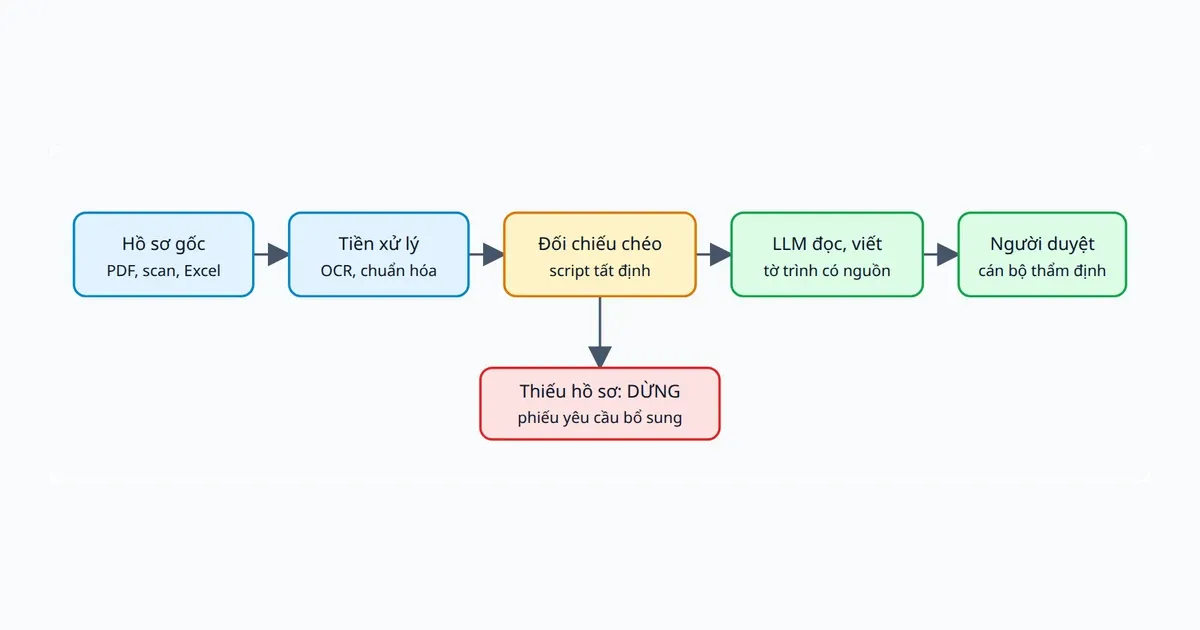
Skill gồm một file hướng dẫn chính, vài tài liệu tham chiếu (ánh xạ hồ sơ vào các mục của tờ trình, quy tắc đối chiếu, mẫu biểu, mô hình phân tích) và một nhóm script nhỏ. Agent đọc hướng dẫn, chạy tiền xử lý, gọi script để tính và đối chiếu, rồi mới viết. Cuối cùng là người duyệt. Mỗi khâu dưới đây là một bài học riêng.
Bài học 1: việc tính toán giao cho script, LLM chỉ đọc, hiểu và viết
Sai lầm tự nhiên nhất là bảo mô hình “tính giúp tôi các chỉ số rồi viết báo cáo”. Mô hình tính nhẩm khá giỏi nhưng không đảm bảo, mà trong tín dụng, một con số lệch là một lỗi nghiêm trọng, hơn nữa lỗi đó lặp lại không đều giữa các lần chạy.
Nên tôi tách vai: mọi phép tính có công thức xác định (chỉ số tài chính, nhu cầu vốn, đối chiếu số liệu giữa các nguồn, xuất file Word) nằm trong script Python. Cùng đầu vào thì ra cùng đầu ra, kiểm thử được, sửa được ở một chỗ. LLM làm phần nó giỏi: đọc tài liệu lộn xộn, hiểu ngữ cảnh, nhận ra điều bất thường, viết lập luận thành văn. Quy tắc tôi ghi vào skill khá đơn giản: số do script sinh ra thì agent trích lại, không tự tính lại.
Bài học 2: không bịa số, thiếu thì dừng lại
Đây là nguyên tắc tôi đặt đầu tiên và đặt cứng. Mọi con số trong báo cáo phải truy được về một tài liệu đã nạp. Khi thiếu tài liệu trọng yếu, agent không được “ước chừng cho đủ bảng”. Nó dừng lại và lập một phiếu yêu cầu bổ sung hồ sơ gửi cho cán bộ.
Thực tế cán bộ đôi khi vẫn phải đi tiếp dù hồ sơ chưa đủ, nên skill có chế độ tiếp tục theo chỉ đạo của người dùng. Nhưng cách đi tiếp cũng có kỷ luật: ô thiếu được đánh dấu tường minh, không giả định theo hướng có lợi cho khách hàng, và chỗ thiếu đó phải xuất hiện trong danh sách cảnh báo rủi ro và thành điều kiện cần hoàn thiện trước khi giải ngân. Tức là thiếu dữ liệu không biến mất, nó biến thành một mục có chủ.
Tôi thấy nguyên tắc này đúng với mọi agent nghiệp vụ: ranh giới giữa “trợ lý hữu ích” và “trợ lý nguy hiểm” thường chỉ là việc nó có dám nói “tôi chưa có dữ liệu này” hay không.
Bài học 3: đối chiếu chéo nhiều nguồn
Một hồ sơ chỉ đáng tin khi các nguồn khớp nhau. Doanh thu trên báo cáo tài chính nên tương xứng với tờ khai thuế và dòng tiền về trên sao kê. Địa chỉ trong đăng ký kinh doanh nên khớp với hợp đồng thuê. Vốn điều lệ trên giấy phép nên khớp với sổ sách. Dư nợ khai báo nên khớp với CIC. Những chỗ lệch chính là nơi rủi ro hoặc gian lận thường lộ ra, và cũng là việc con người dễ bỏ sót khi đã mệt.
Tôi gom các phép đối chiếu này thành một script riêng và một tài liệu mô tả ý nghĩa của từng phép. Script báo lệch, còn việc lệch đó vô hại (chênh lệch thời điểm, khác chuẩn ghi nhận) hay đáng ngại là việc của người thẩm định. Tôi cố tình không để agent tự “giải thích cho trơn” các chênh lệch, vì mô hình rất giỏi bịa ra lý do nghe có vẻ hợp lý.
Bài học 4: tài liệu scan cần tiền xử lý OCR riêng
Một phần lớn hồ sơ thật là bản scan hoặc ảnh chụp: báo cáo tài chính đã ký, hợp đồng, giấy tờ pháp lý. Nếu bắt agent vừa đọc ảnh vừa phân tích trong cùng một lượt thì vừa chậm, vừa dễ sai, vừa tốn ngữ cảnh. Cách tôi làm là đưa tài liệu qua một bước tiền xử lý: phân loại file nào là văn bản số, file nào là scan, scan thì OCR (bằng mô hình thị giác), chuyển hết sang Markdown hoặc JSON có cấu trúc và lưu cache. Agent thẩm định sau đó chỉ làm việc trên dữ liệu đã sạch.
Hai điều rút ra. Một, chất lượng của khâu này quyết định trần chất lượng của cả skill, nên nó đáng được kiểm tra bằng mắt ở những trường quan trọng. Hai, tách bước này ra còn giúp chạy lại phân tích nhiều lần mà không phải OCR lại từ đầu.
Bài học 5: thử trên dữ liệu giả lập để biết skill có tổng quát hóa không
Rủi ro lớn của một skill nghiệp vụ là vô tình “học thuộc” bộ hồ sơ dùng để chỉnh nó: chạy rất đẹp trên đúng một khách hàng, đổ khi gặp khách hàng khác. Vì vậy tôi dựng thêm một doanh nghiệp giả lập hoàn toàn, với đủ chín nhóm hồ sơ, số liệu tự nghĩ ra nhưng nhất quán nội bộ, và cố ý khác về ngành nghề, quy mô, cấu trúc công nợ so với bộ hồ sơ ban đầu. Sau đó cho skill chạy lên bộ giả lập mà không chỉnh thêm gì.
Cách làm này có hai lợi ích ngoài việc kiểm tra tổng quát hóa. Dữ liệu giả lập không dính vấn đề bảo mật nên chia sẻ, tái chạy và đưa vào kiểm thử tự động thoải mái. Và tôi có thể chủ động cài lỗi vào đó (thiếu một nhóm hồ sơ, hai nguồn lệch nhau) để xem skill có bắt được không.
Bài học 6: chấm điểm đầu ra bằng rubric và chạy vòng lặp
“Báo cáo trông ổn” là thước đo tệ. Tôi viết một bộ chấm điểm theo rubric: chia tờ trình thành vài nhóm nội dung (pháp lý, quan hệ tín dụng, tài chính, nhu cầu vốn, tuân thủ điều kiện sản phẩm, đề xuất và cảnh báo…), mỗi nhóm có trọng số và một danh sách chỉ tiêu phải có, kèm bằng chứng tìm thấy trong bài. Điểm đạt ngưỡng nào đó thì coi là qua. Rồi vòng lặp là: chạy skill, chấm, xem chỗ nào mất điểm, sửa hướng dẫn hoặc script, chạy lại.
Rubric kiểu này có giới hạn tôi cần nói thật: nó đo độ đầy đủ và sự hiện diện của thông tin, chưa đo được chất lượng phán đoán. Một báo cáo có thể đủ mọi mục mà kết luận vẫn yếu. Điểm cao chỉ cho biết agent không bỏ sót, không cho biết nó đúng. Rubric là lưới an toàn tối thiểu, không thay cho việc người có kinh nghiệm đọc lại.
Giới hạn: AI hỗ trợ, không thay thẩm định viên
Tôi muốn nhấn mạnh phần này nhất. Skill được thiết kế để làm bản nháp và danh sách điểm cần kiểm tra cho cán bộ quan hệ khách hàng và thẩm định viên, không phải để ra quyết định cấp tín dụng. Quyết định cấp tín dụng có hậu quả pháp lý và tài chính, và trách nhiệm đó thuộc về con người và quy trình phê duyệt của tổ chức. Một vài nguyên tắc tôi giữ:
- Mọi số liệu đều có nguồn dẫn để người duyệt kiểm tra nhanh được.
- Cảnh báo rủi ro được đưa lên đầu, không chôn trong văn bản.
- Đừng để việc “báo cáo đã đẹp sẵn” làm người duyệt lơ là. Báo cáo càng trơn tru, càng phải cảnh giác với lỗi tinh vi.
- Dữ liệu hồ sơ khách hàng là dữ liệu nhạy cảm, cần tuân thủ chính sách bảo mật của tổ chức trước khi đưa vào bất kỳ công cụ AI nào.
Kết
Nếu phải rút gọn: để script lo phần tất định, để LLM lo phần đọc hiểu và viết, cấm bịa số và dám dừng lại khi thiếu, đối chiếu chéo, OCR tách riêng, kiểm tra tổng quát hóa trên dữ liệu giả lập, và chấm điểm bằng rubric trong một vòng lặp. Những nguyên tắc này không riêng gì tín dụng, chúng áp dụng được cho kế toán, pháp chế hay kiểm toán nội bộ. Và dù skill giỏi đến đâu, người ký vẫn là con người.